微服务框架原理与治理实现
微服务架构介绍
系统架构的演进历史
单体架构
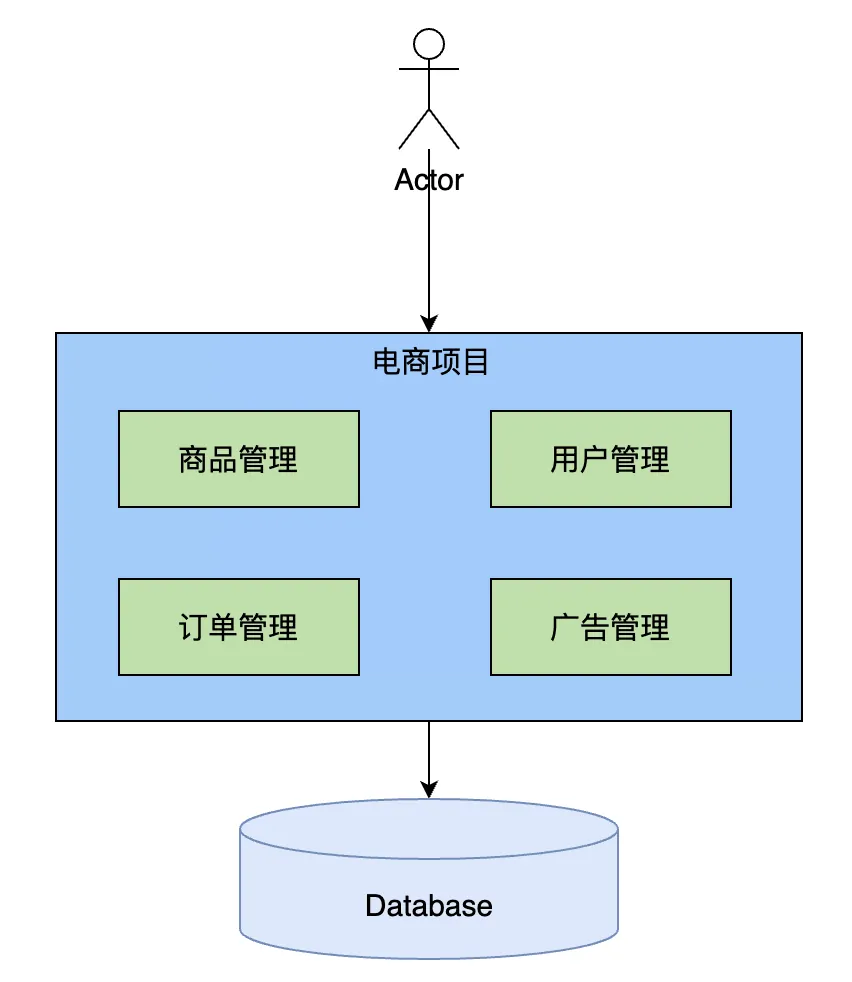
All in one process
优势
- 性能最高
- 冗余小
劣势
- debug 困难
- 模块相互影响
- 模块分工、开发流程
垂直应用架构
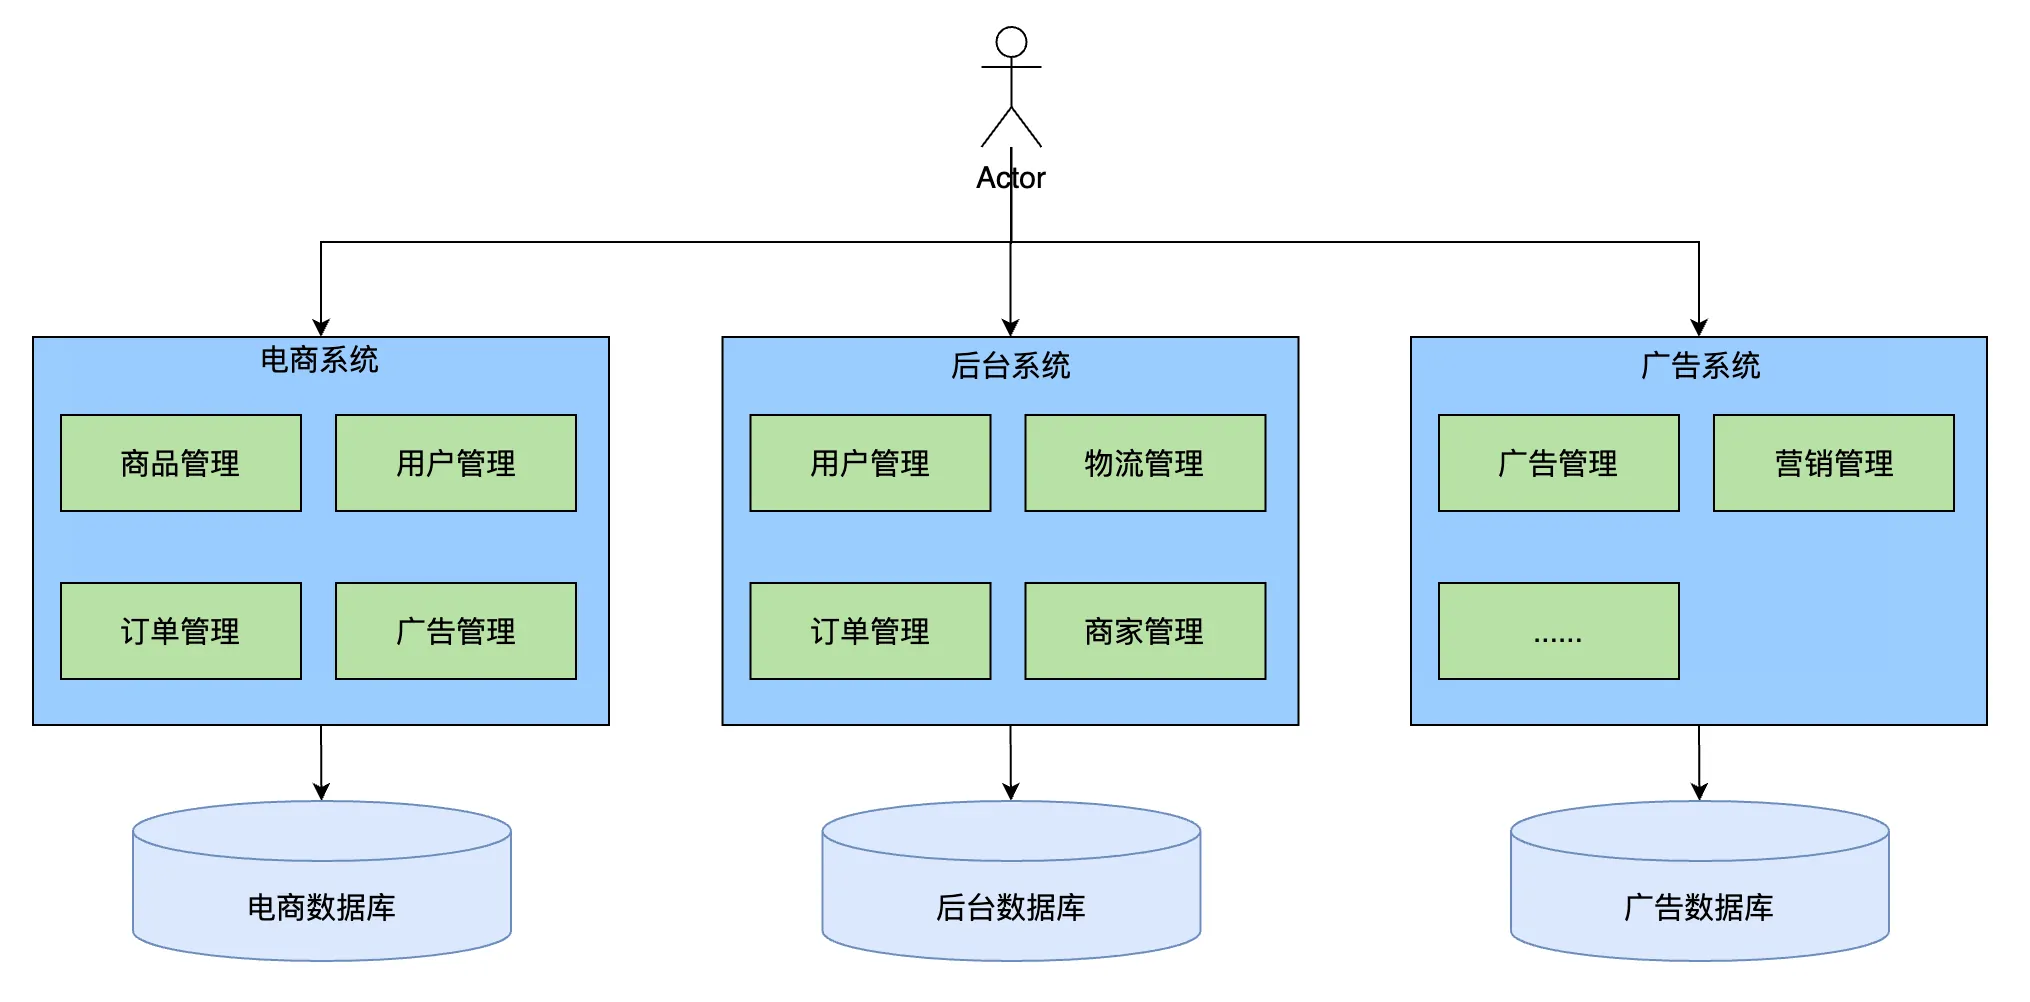
按照业务线垂直划分
优势
- 业务独立开发维护
劣势
- 每个业务存在冗余
- 每个业务都还是单体
分布式架构
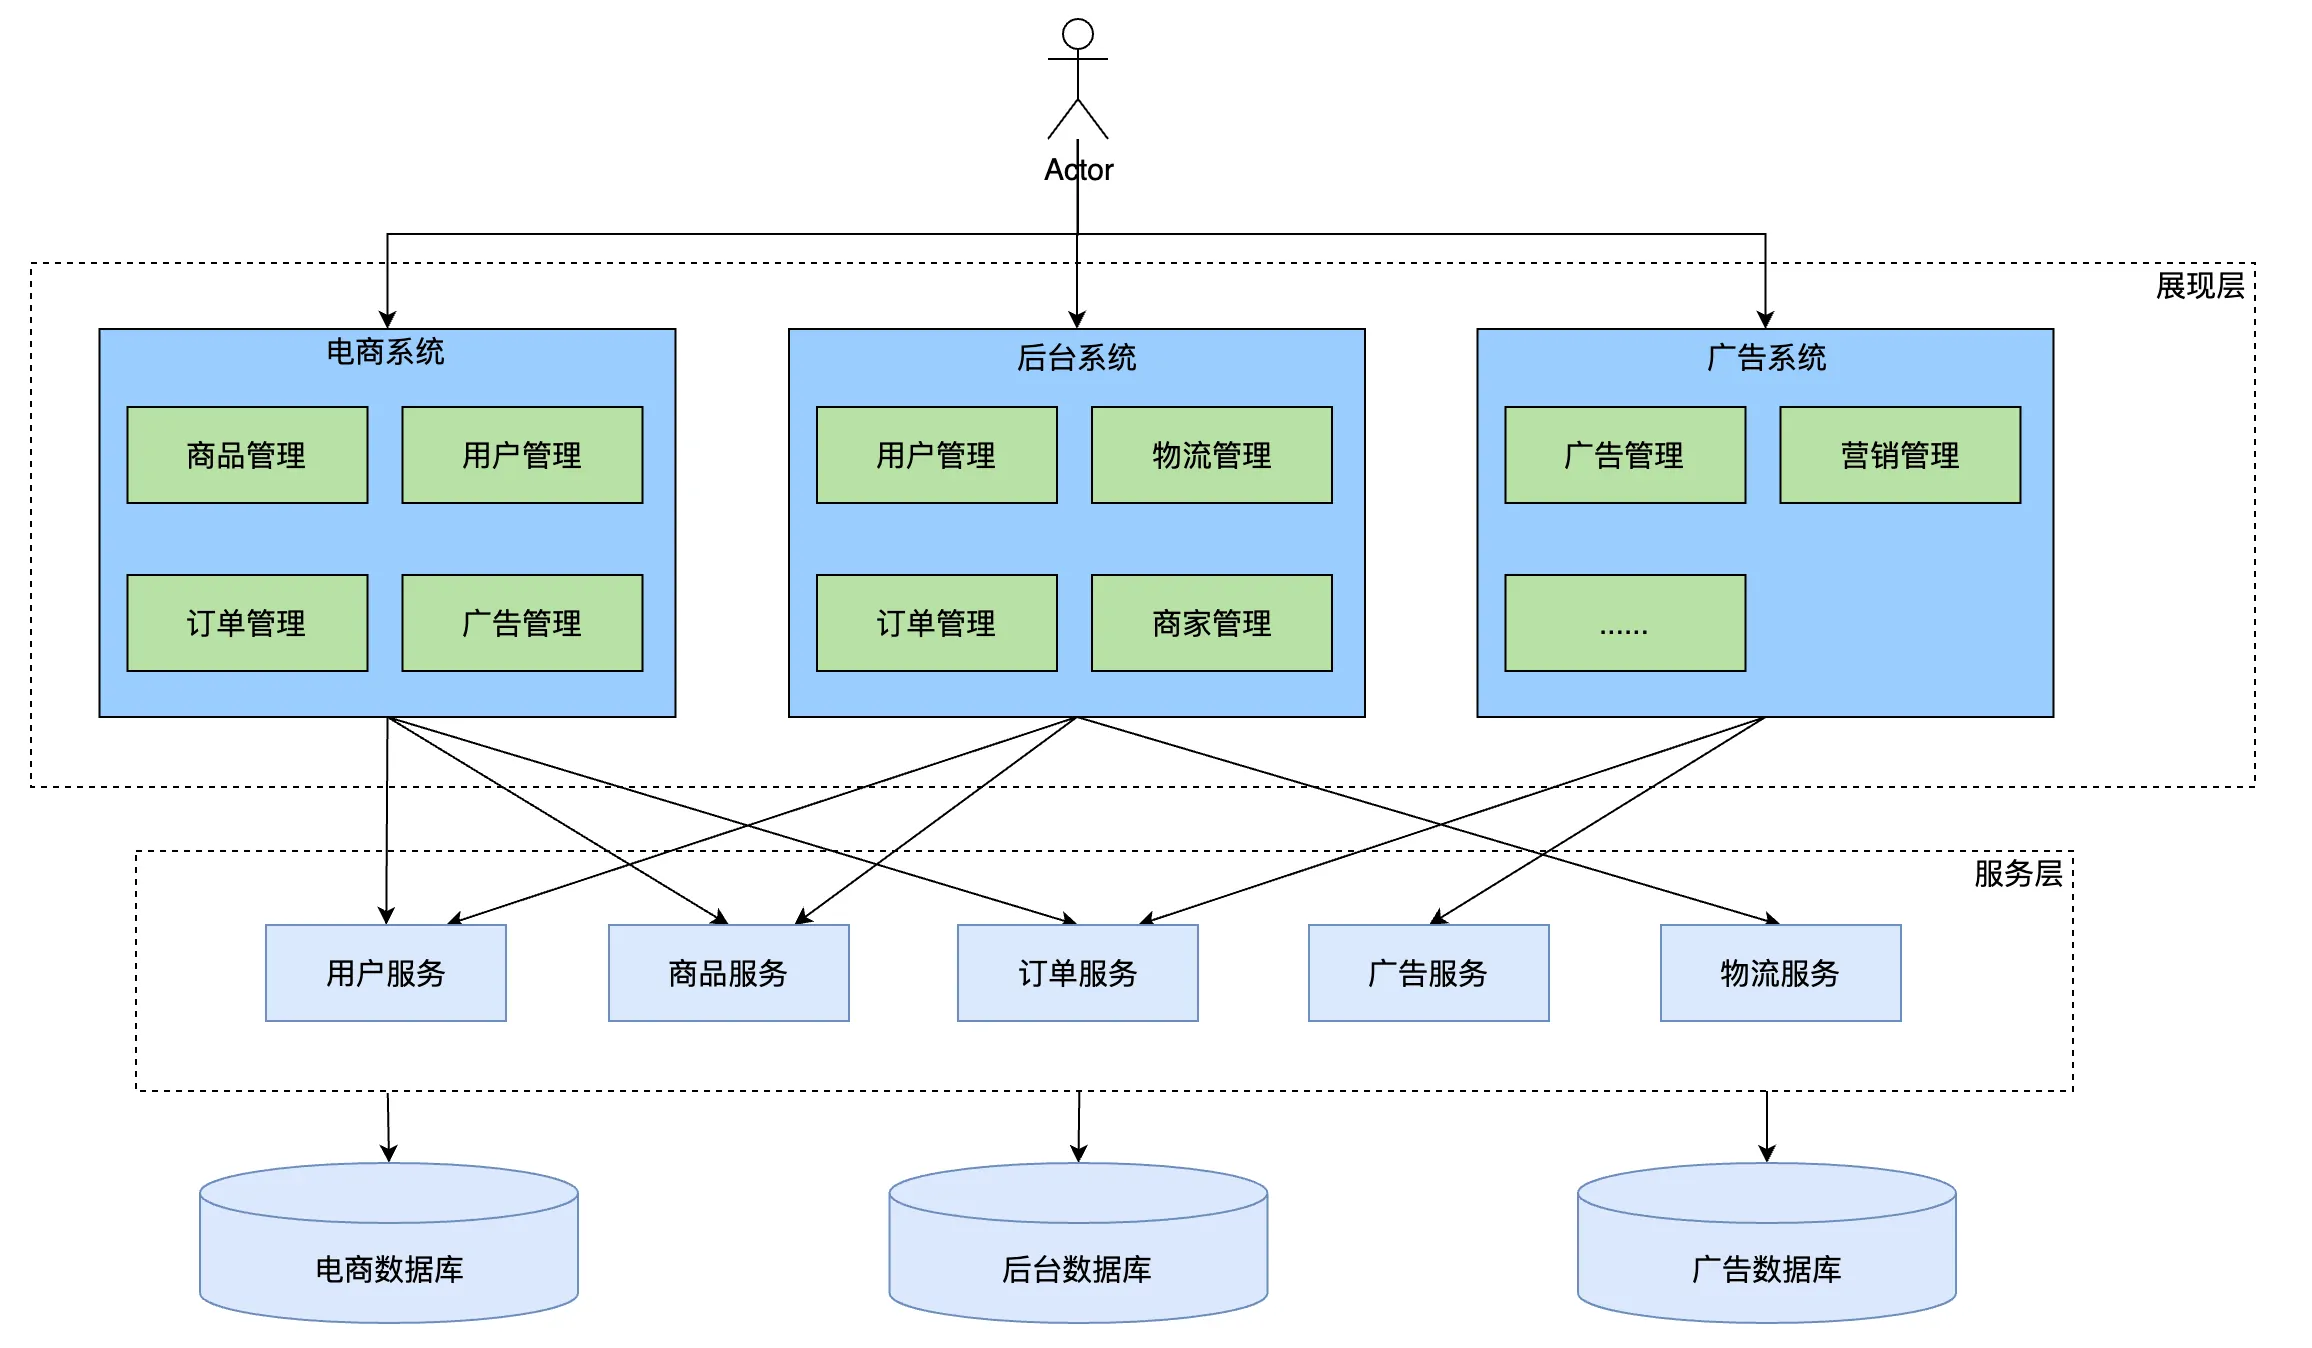
- 抽出与业务无关的公共模块
- 优势
- 业务无关的独立服务
- 劣势
- 服务模块 bug 会导致全站崩溃
- 调用关系复杂
- 不同服务荣誉
SOA架构
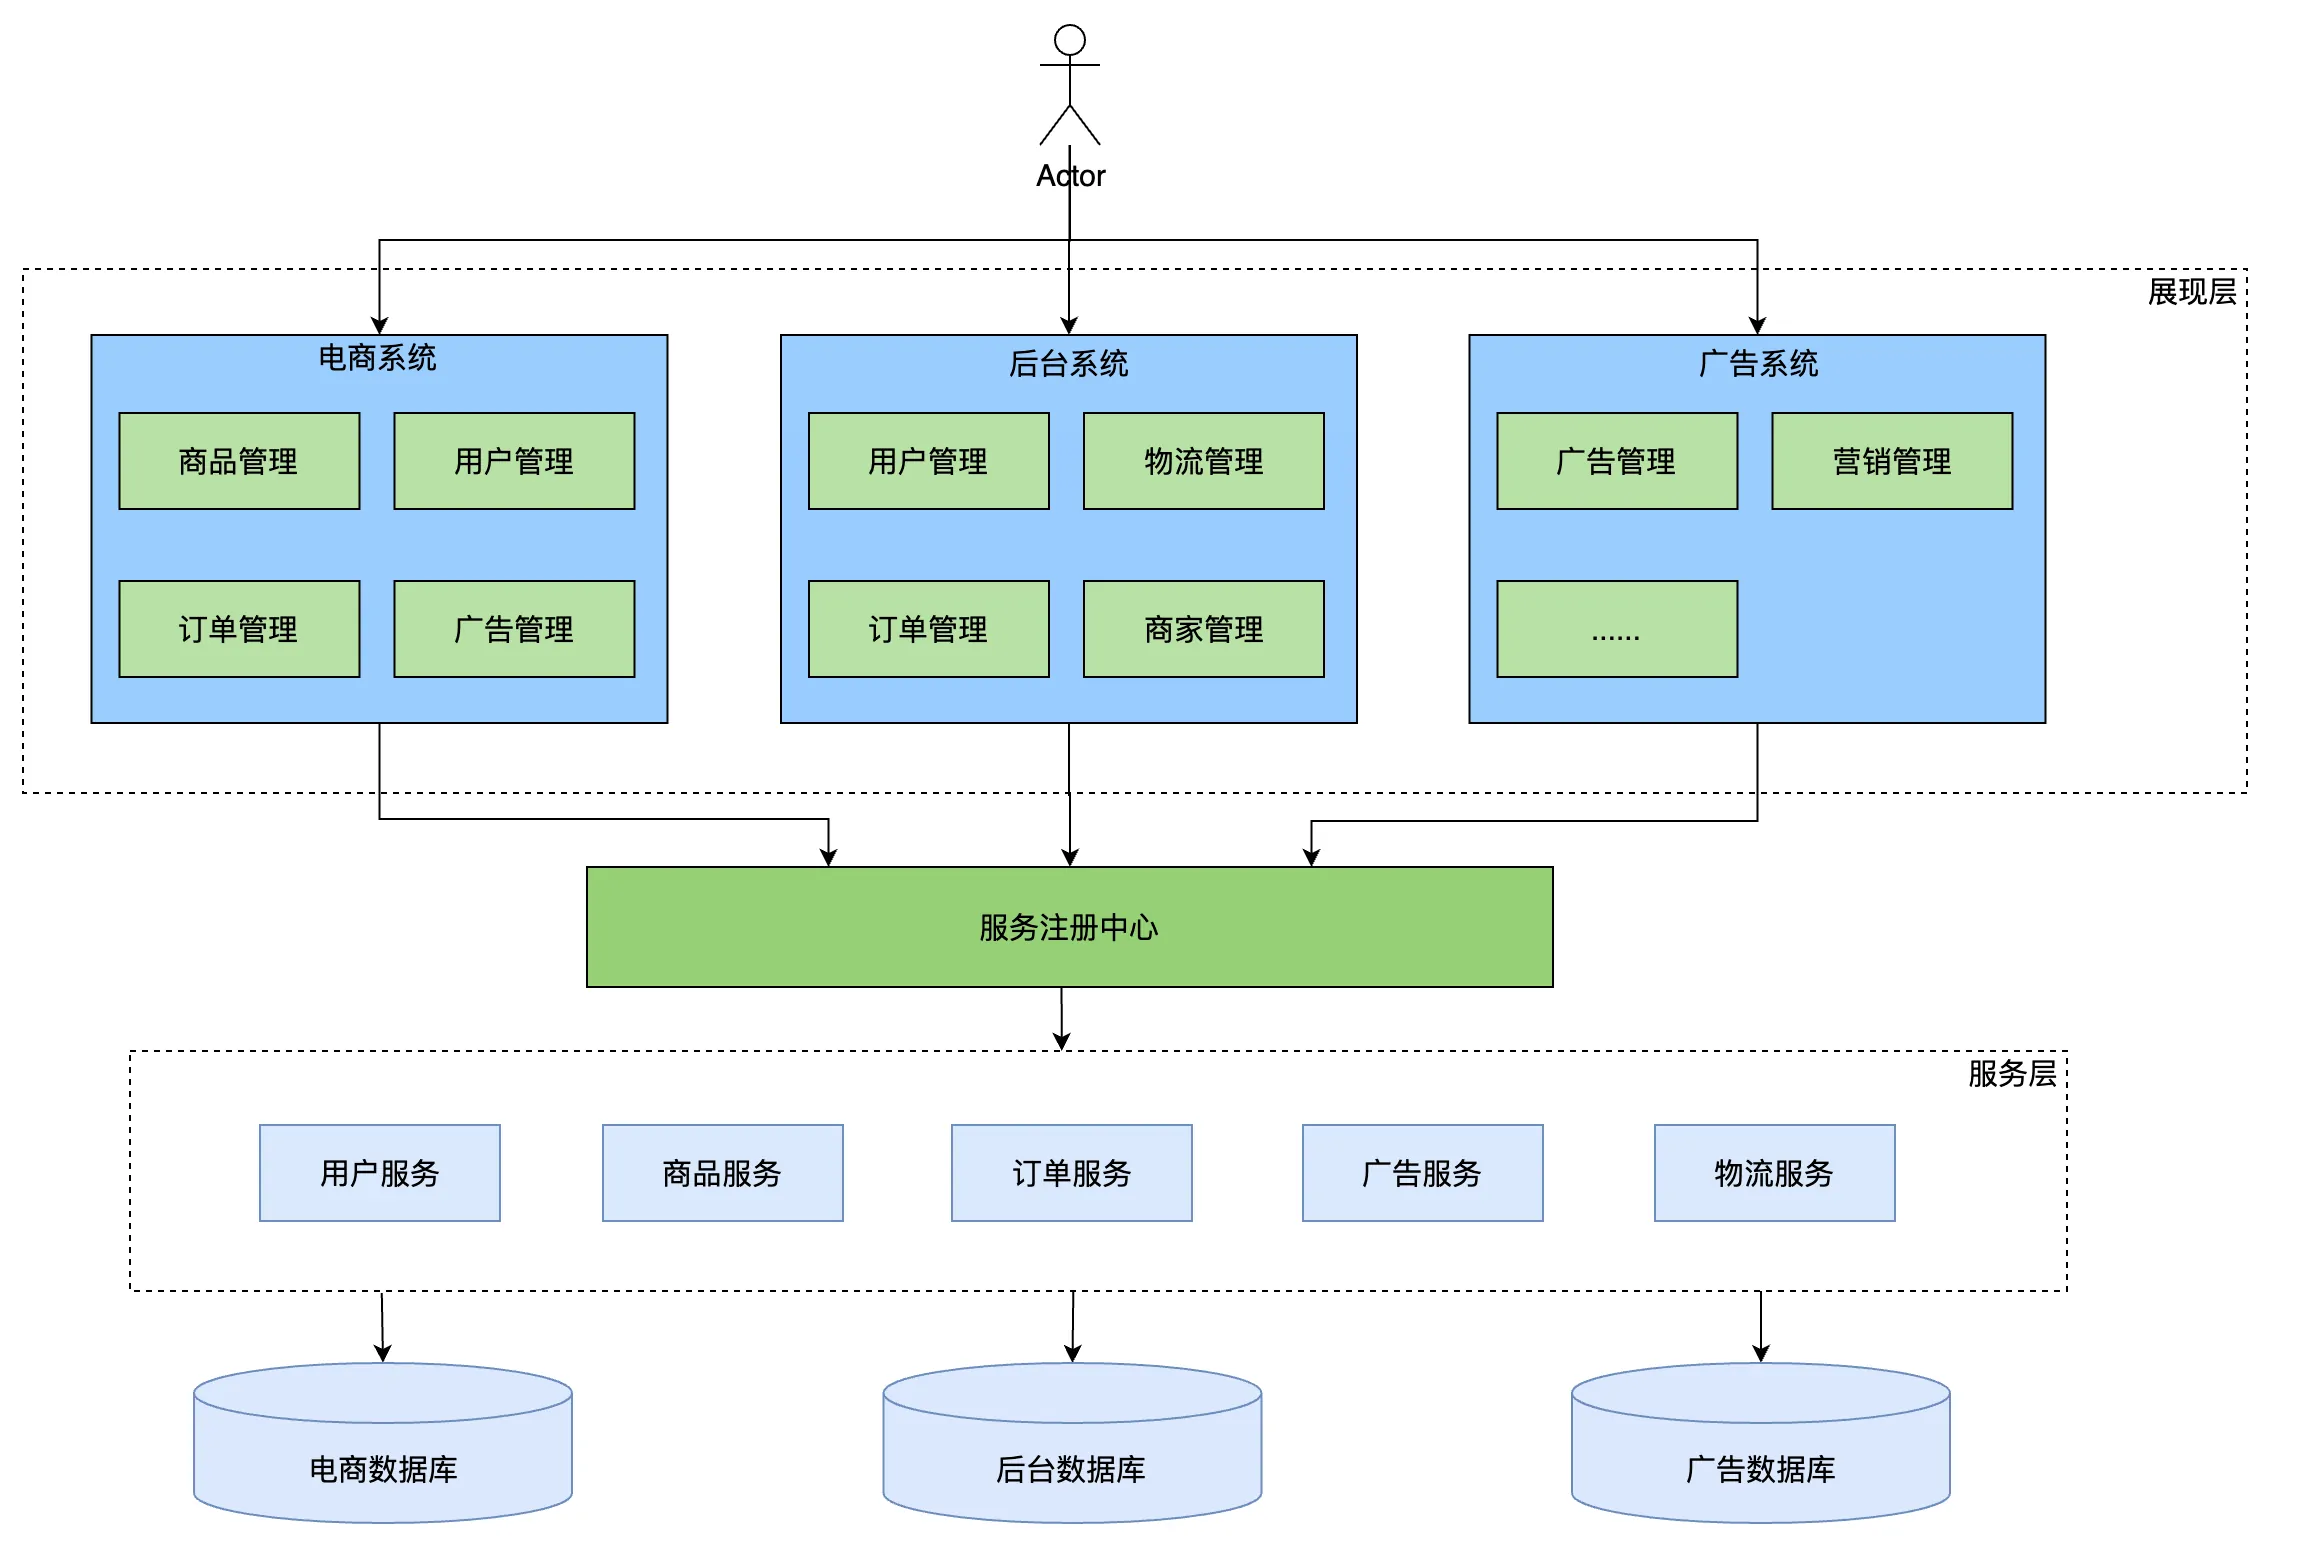
- 面向服务
- 优势
- 服务注册
- 劣势
- 整个系统设计必须是中心化的
- 需要自上而下设计
- 重构困难
微服务架构
- 彻底的服务化
- 优势
- 开发效率
- 业务独立设计
- 自下而上
- 故障隔离
- 劣势
- 治理、运维难度
- 观测困难
- 安全性较弱
其他架构
- 例如 Servier Mesh
微服务架构概览
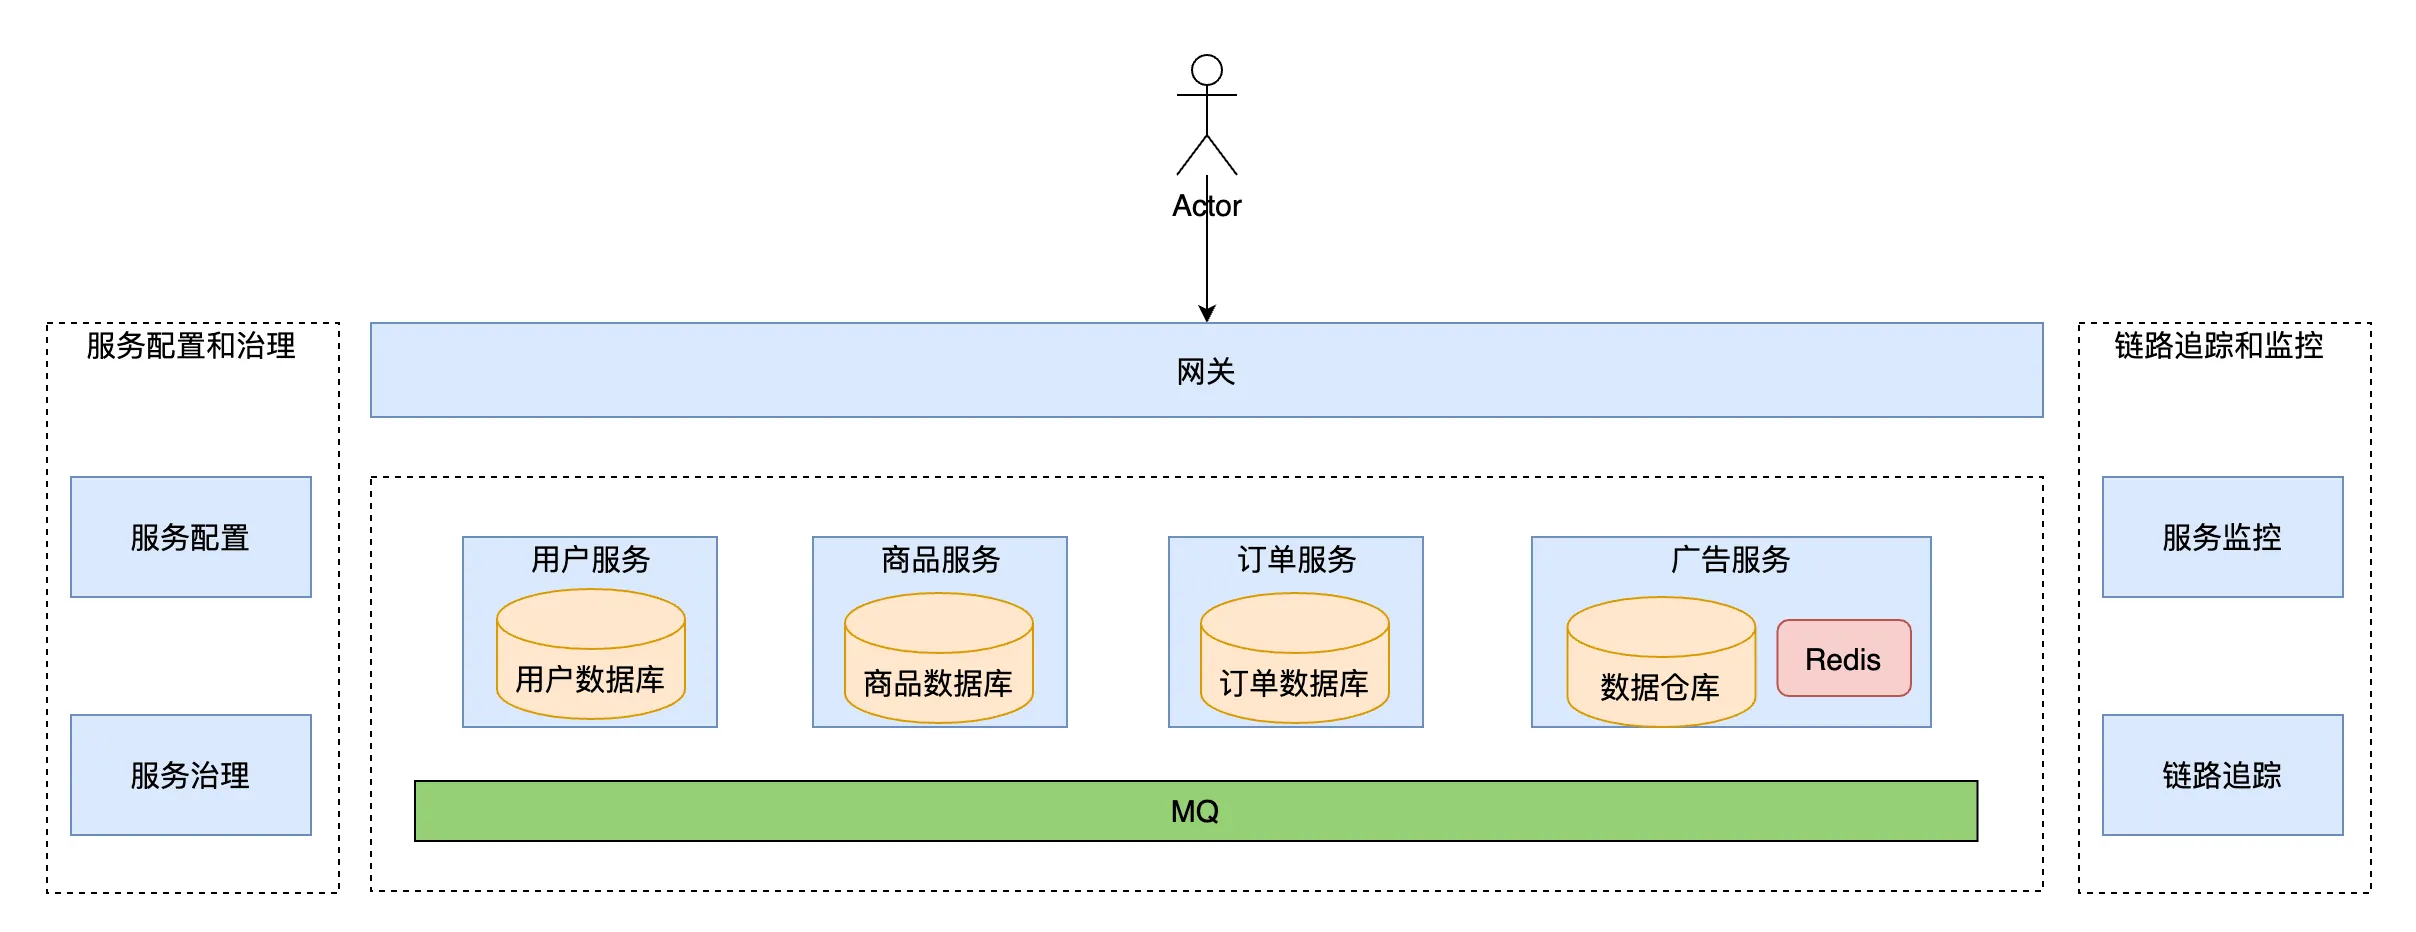
网关
处理流量
连接核心组件
服务配置和治理
链路追踪和监控
- 使用一个单独的平台进行追踪
微服务架构的三大要素
服务治理
- 服务注册
- 服务发现
- 负载均衡
- 扩缩容
- 流量治理
- 稳定性治理
可观测性
- 日志采集
- 日志分析
- 监控打点
- 监控大盘
- 异常报警
- 链路追踪
- 传统:根据单机的调用栈就可以很轻松的找到问题点
- 微服务:跨机器,调用链路长,很难定位问题点
安全
- 身份验证
- 认证授权
- 访问令牌
- 审计
- 传输加密
- 黑产攻击
微服务架构原理及特征
微服务架构中的基本概念及组件
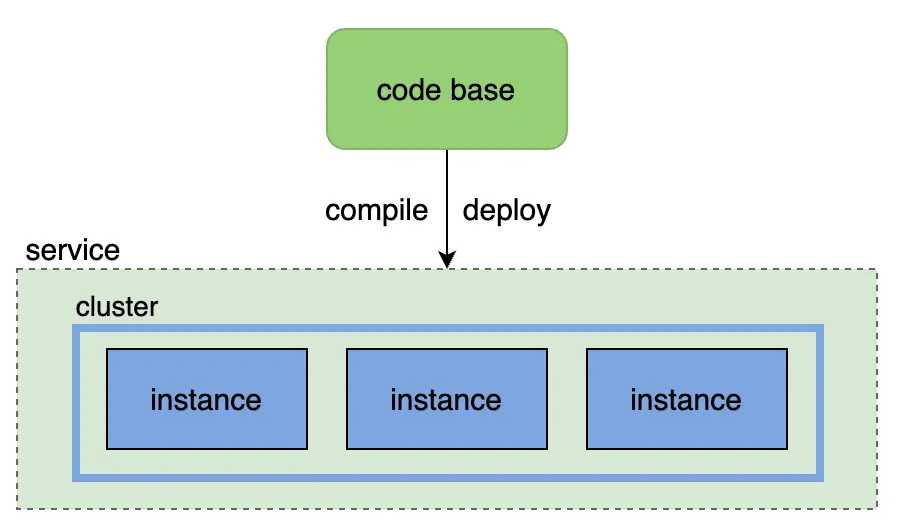
服务 (Service)
- 一组具有相同逻辑的运行实体
实例 (Instance)
- 一个服务中的每个运行实体
实例与进程的关系
- 没有必然对应关系,一般一对一或者一对多
集群 (Cluster)
- 通常指服务内部的逻辑划分,包含多个实例
常见的实例承载形式
- 进程、VM、k8s pod......
有状态 / 无状态服务
- 服务的实例是否存储了可持续化的数据(例如磁盘文件)
服务间通信
对于单体服务,不同模块通信只是简单的函数调用
对于微服务,服务通信通常意味着网络传输
- 微服务之间通过网络进行通信
- 常见的通信协议包括 HTTP、RPC
服务注册及服务发现
基本问题
- 服务间调用中,如何指定下游服务实例的地址?
简单方案
直接指定 ip : port?
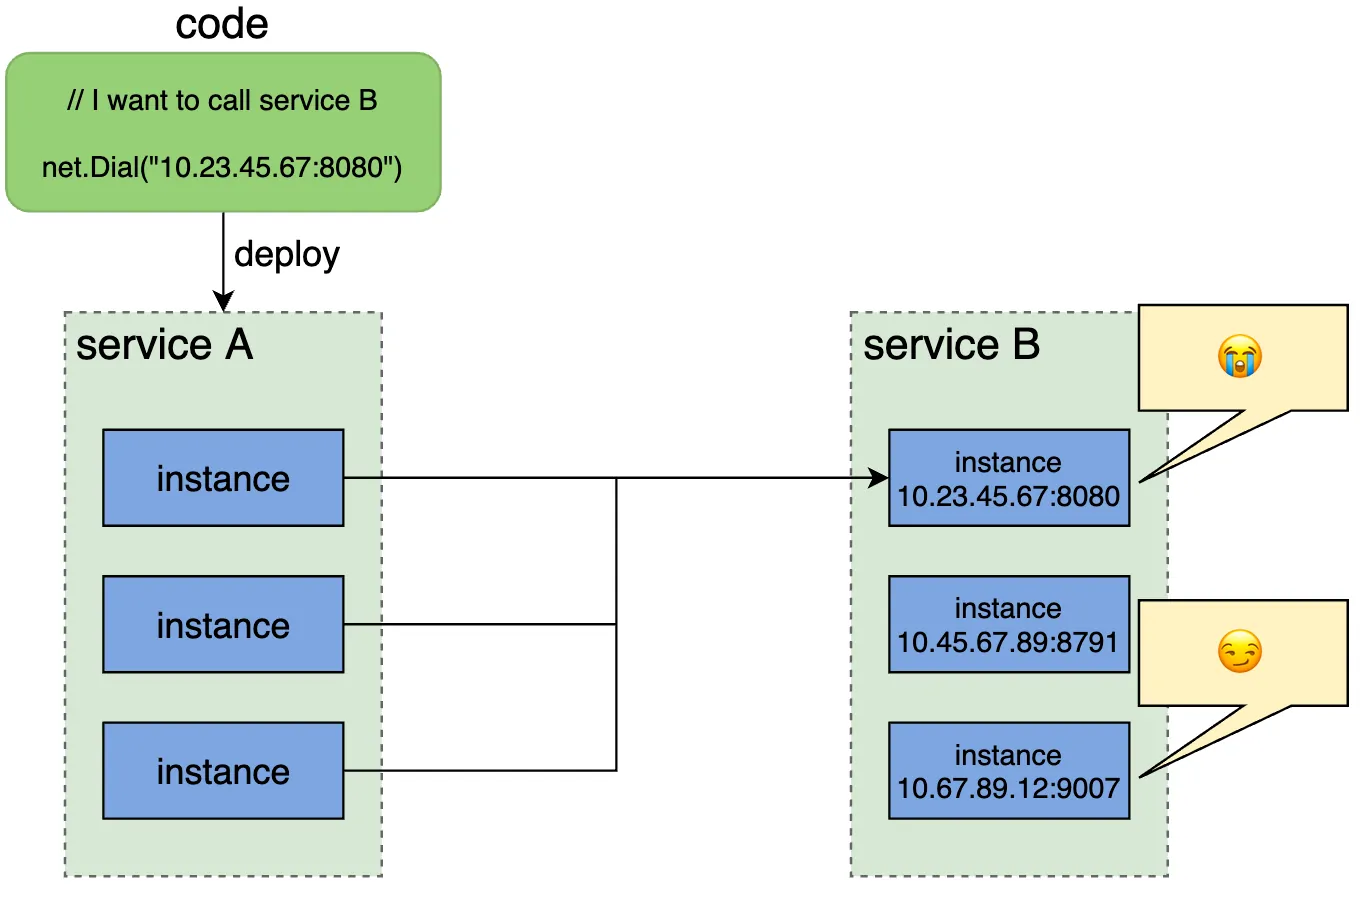
- 没有任何动态能力
- 有多个实例下游实例怎么办?(一般情况只下会找到第一个)
使用 DNS?
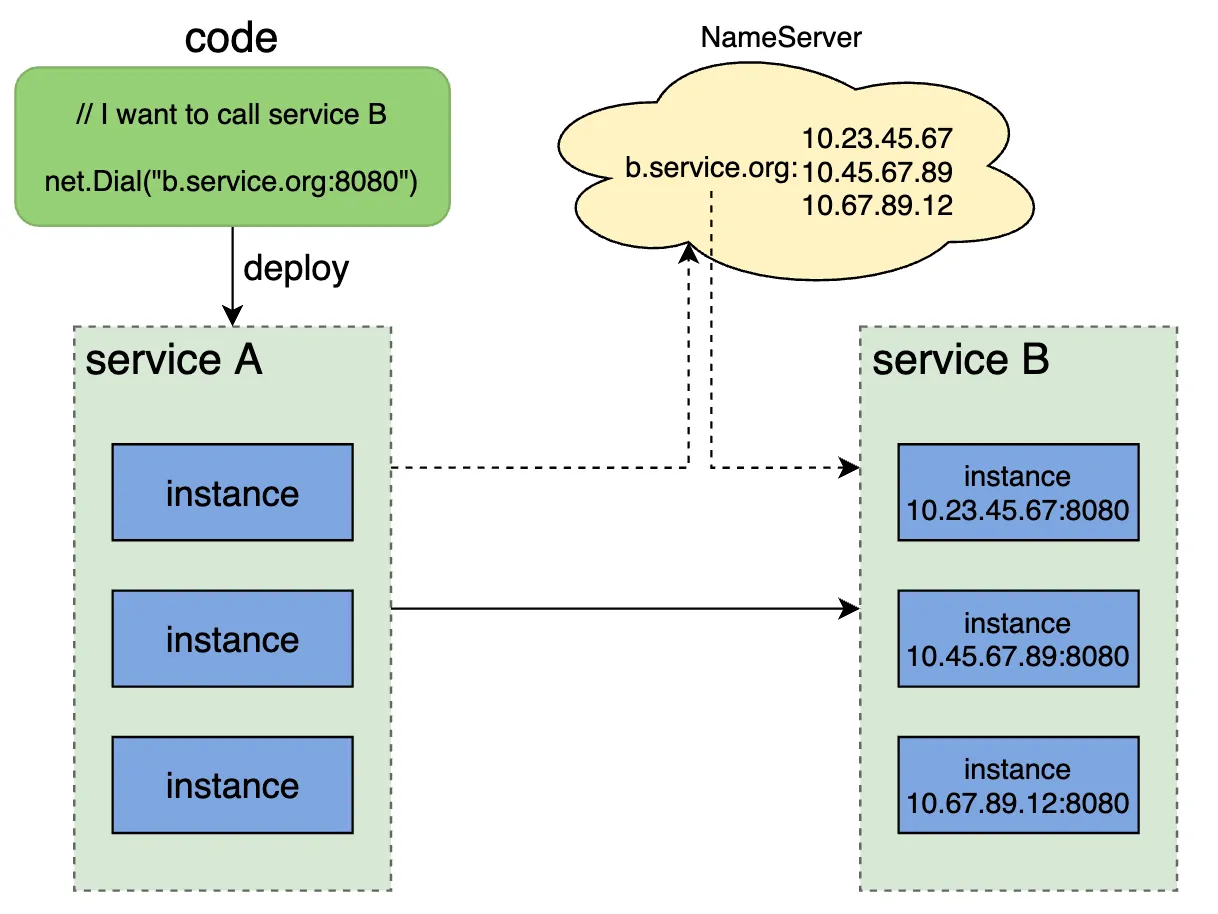
- 本地 DNS 存在缓存,导致延迟
- DNS 没有负载均衡
- 不支持服务探活检查
- DNS 不能指定端口(域名不能指定端口)
一个好的解决方案
服务注册发现
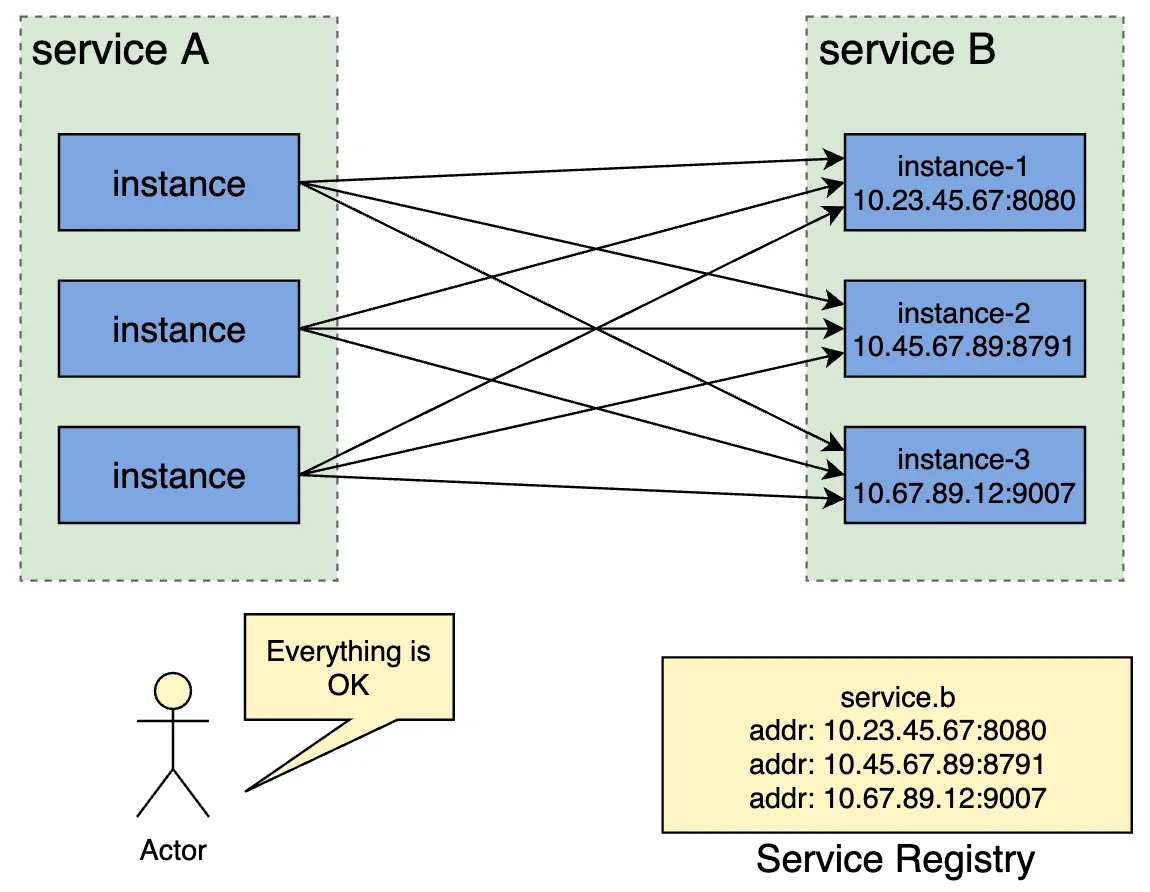
- 新增一个统一的服务注册中心,用于存储服务名到服务实例之间的映射关系
- 类似于一个微服务的 Hash Map
- 旧服务实例下线前,从服务注册中心删除该实例(请求超时),下线流量
- 新服务实例上线后,在服务注册中心注册该实例(健康检查),上线流量
- 新增一个统一的服务注册中心,用于存储服务名到服务实例之间的映射关系
微服务流量特征
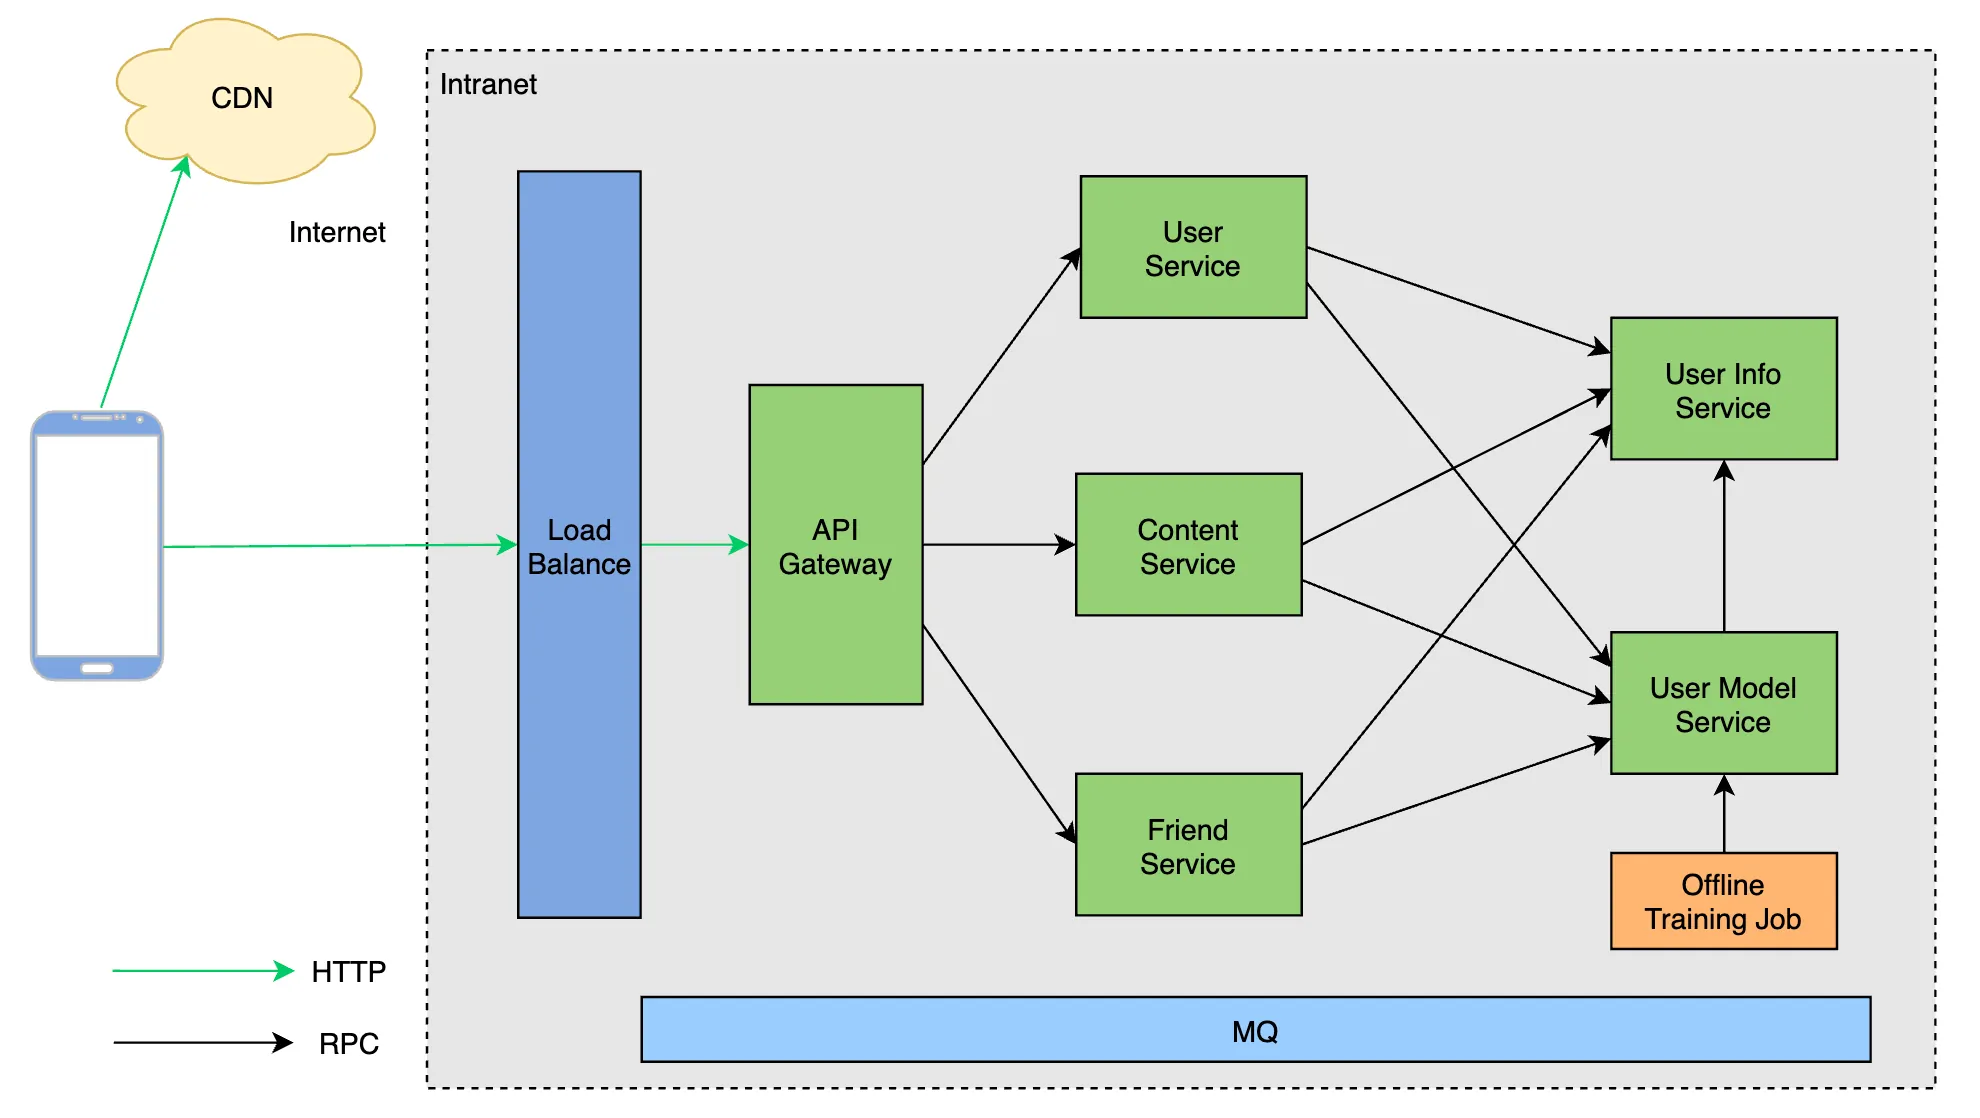
- 统一网关入口
- 外网通信多数采用 HTTP,内网通信多数采用 RPC(Thrift, gRPC)
- 内部为网状调用链路
核心服务治理功能
服务发布
何为服务发布 (deployment)?
- 让一个服务升级运行新的代码的过程
服务发布难点
蓝绿部署
灰度发布(金丝雀发布)
流量治理
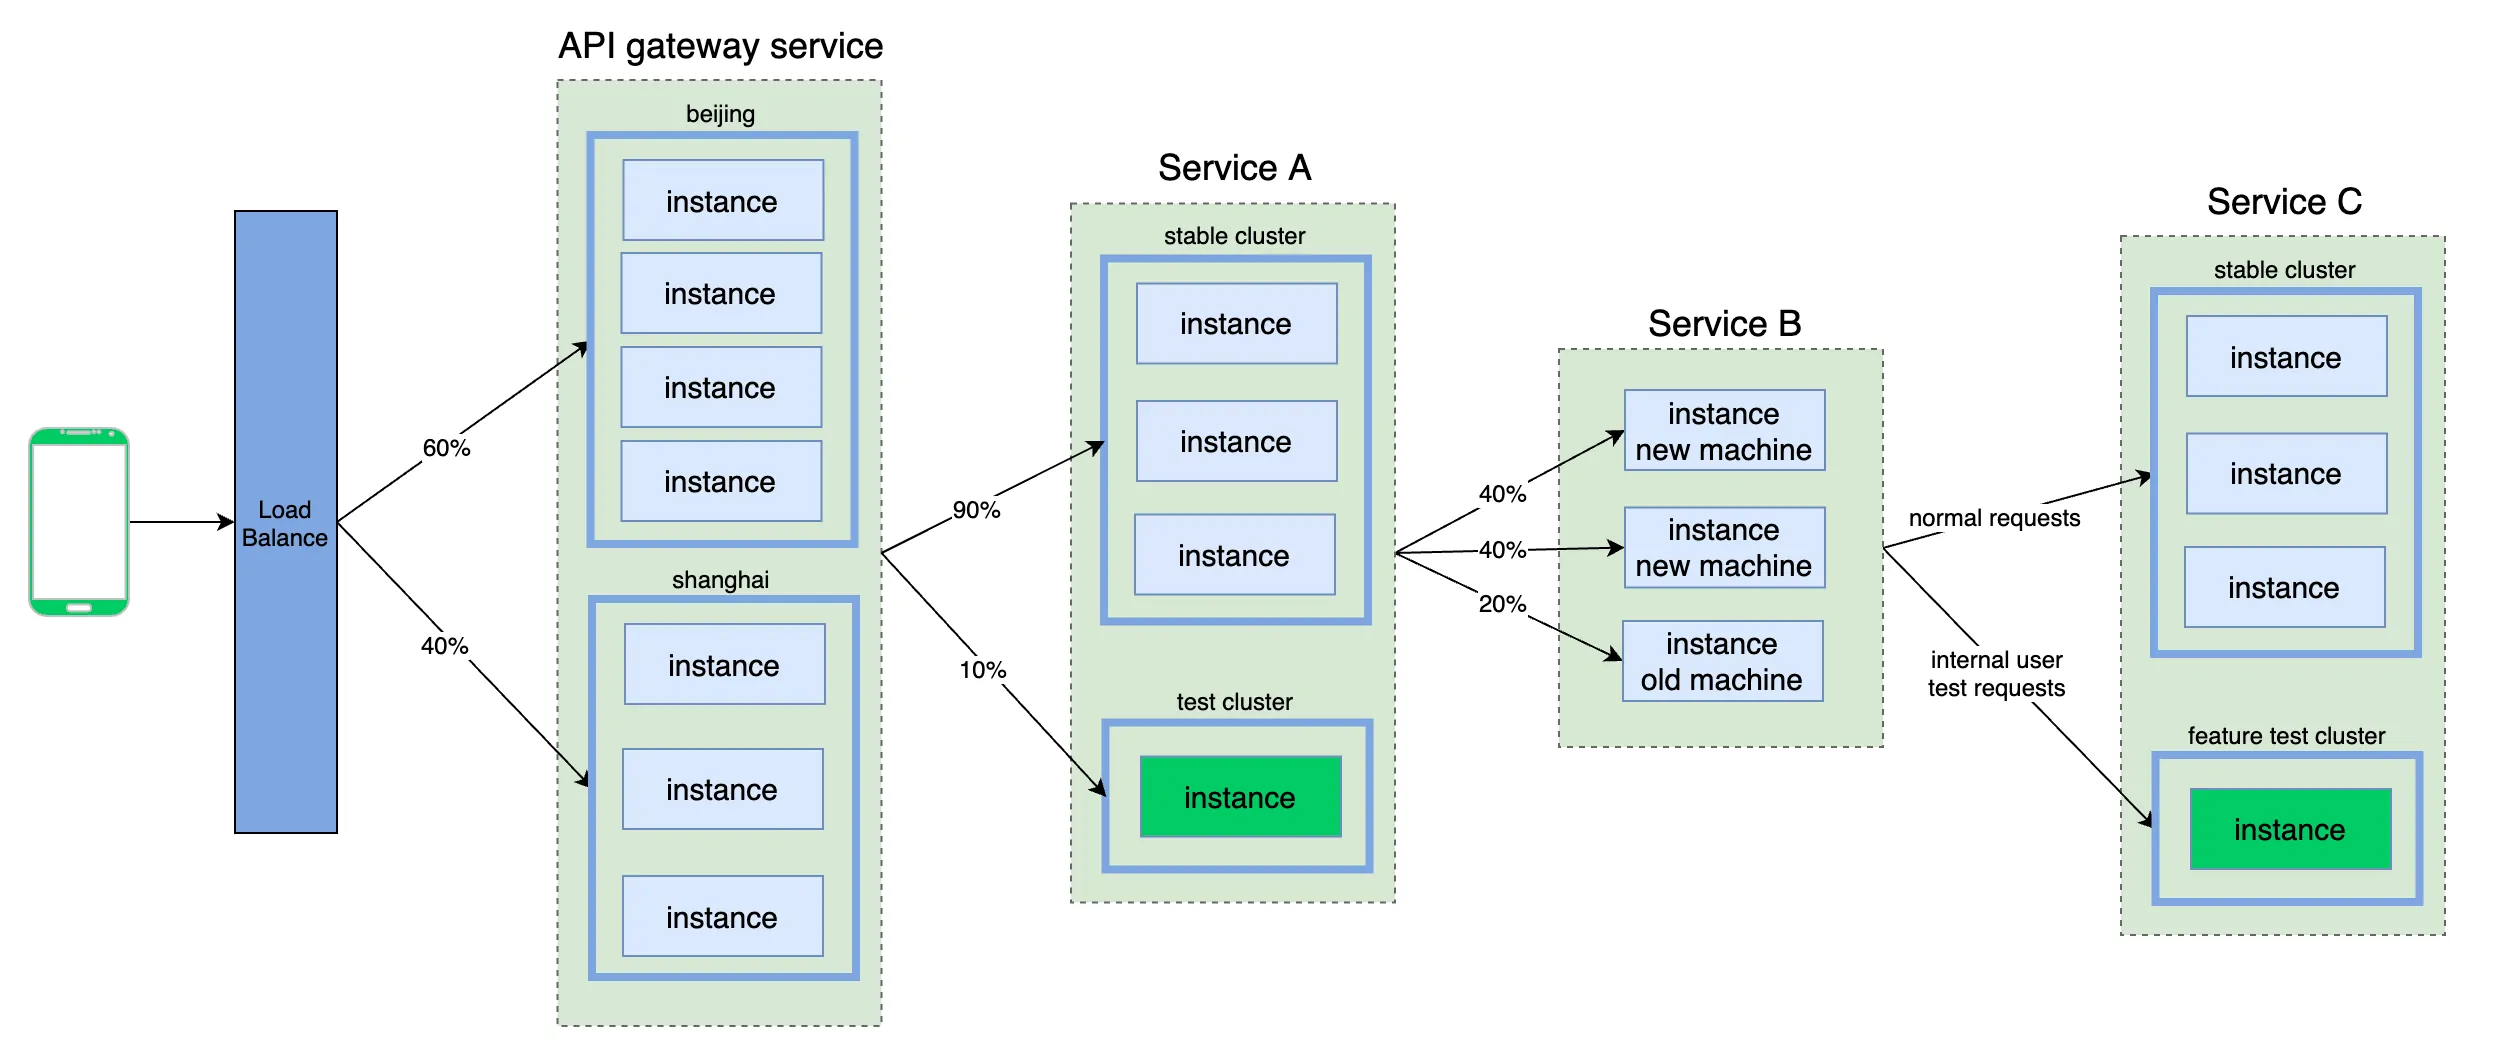
在微服务架构中,我们可以基于:
- 地区维度
- 集群维度
- 实例维度
- 请求维度
- ……
实现对端到端的流量在链路上进行精确控制
负载均衡(Load Balance)
负载均衡负载分配请求在每个下游实例上的分布
Round Robin
- 绝对均衡
Random
- 随机
Ring Hash
- 一致性哈希
Least Request
稳定性治理
线上服务总是会出问题的,这与程序的正确性无关
客观故障
网络攻击
流量突增
机房断电
光纤被挖(支付宝。。
机器故障
网络故障
机房空调故障
……
治理功能
限流(rate limit)
服务端功能
限制服务处理的最大 QPS,拒绝过多请求
熔断
请求端功能
中断请求路径,增加冷却时间从而让故障实例尝试恢复
过载保护
服务端功能
在负载高的实例中,主动拒绝一部分请求,防止实例被打挂
降级
服务端功能(负载均衡服务器)
服务处理能力不足时,拒绝低级别的请求,只响应线上高优请求
比如允许用户的正常请求,拒绝内部的测试请求
字节跳动服务治理实践
请求重试
区别本地与远程
本地函数调用通常没有重试意义
远程函数调用
- 网络抖动、下游负载高、下游机器宕机......
- 重试是有意义的,可以避免偶发性的错误,提高 SLA
- SLA (Service-Level Agreement)
重试的意义
- 降低错误率
- 若单次请求错误概率为 0.01,那么连续两次错误的概率为 0.0001
- 降低长尾延时
- 对于偶尔耗时较长的请求,重试请求有机会提前返回
- 容忍暂时性错误
- 某些时刻,系统会出现暂时性异常(例如网络抖动),重试可以尽可能避免
- 避开下游故障实例
- 一个服务中可能会有少量实例故障
但是一般默认不用!!!
请求重试的难点
幂等性
- POST 请求可以重试吗?
重试风暴
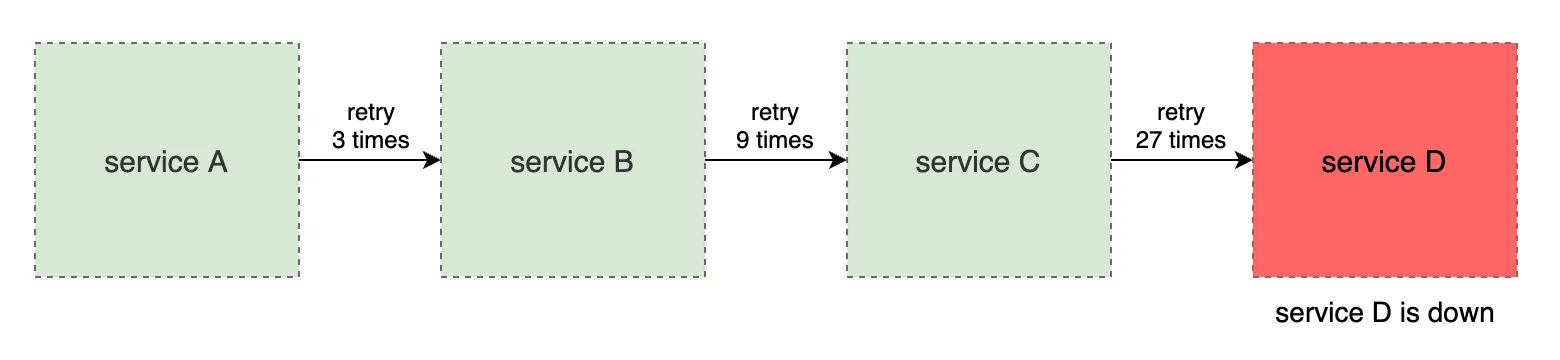
- 随着调用链路的增加,重试次数呈指数级上升
超时设置
- 假设调用时间一共1s,经过多少时间开始重试?
应对 “重试风暴”
限制重试比例
- 设定一个重试比例阈值(例如 1%),重试次数占所有请求比例不超过该阈值
防止链路重试
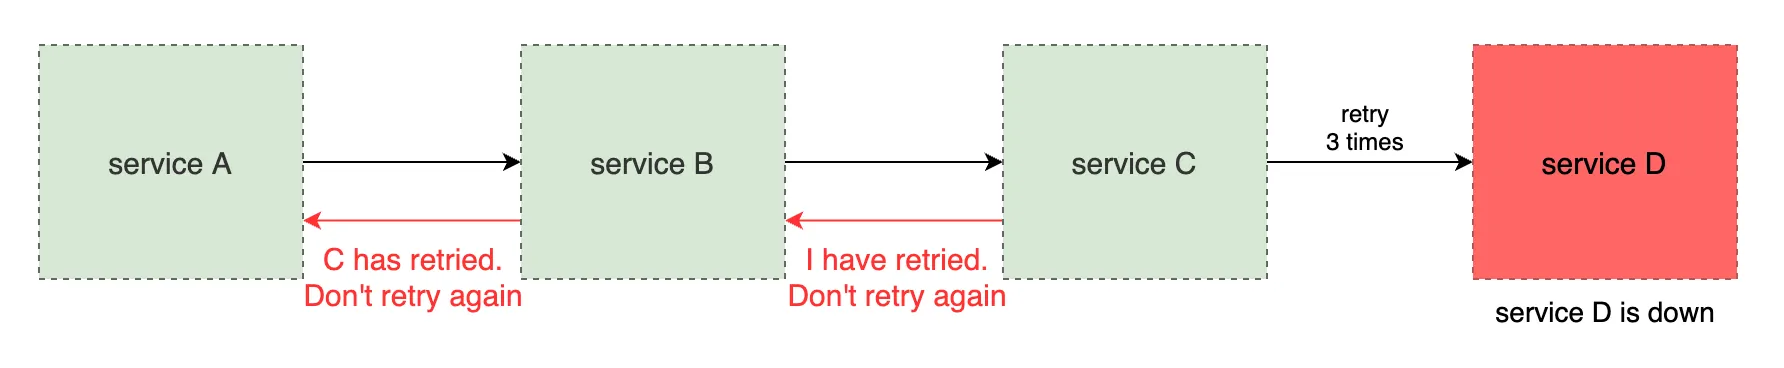
- 返回特殊的 status code,表示“请求失败,但别重试”
Hedged Requests
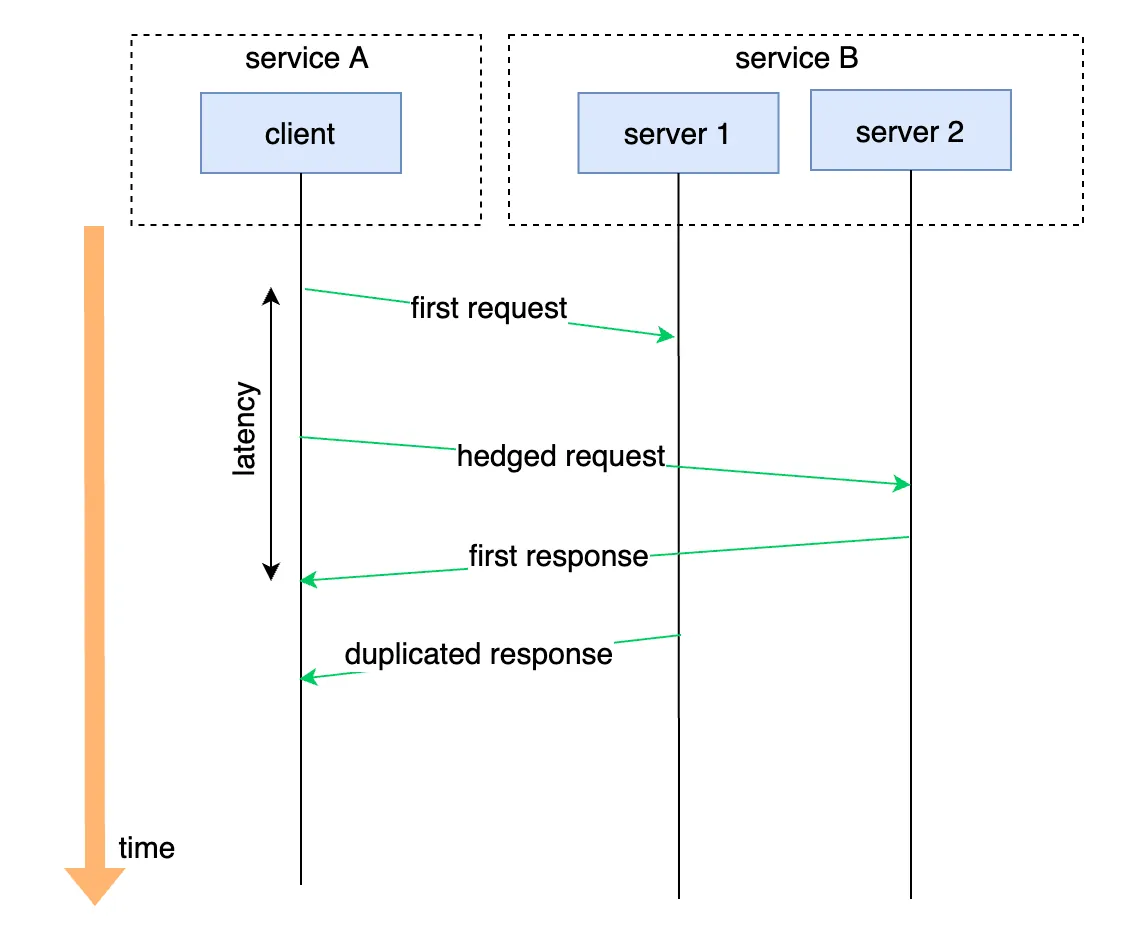
- 对于可能超时(或延时高)的请求,重新向另一个下游实例发送一个相同的请求,并等待先到达的响应
Q.E.D.
评论
登录后即可发表评论